چرا صدای ضبطشدهی خودمان برایمان عجیب است؟
چون ما صدای خودمان را هنگام حرفزدن با دو مسیر متفاوت میشنویم، اما در فایل ضبطشده فقط یکی از آنها باقی میماند.
وقتی صحبت میکنیم، بخشی از صدا از راه هوا وارد گوش میشود؛ همان مسیری که صدای دیگران را میشنویم. اما همزمان لرزش تارهای صوتی و استخوانهای جمجمه هم مستقیماً به گوش داخلی منتقل میشود. این مسیر که «هدایت استخوانی» نام دارد، معمولاً باعث میشود صدای خودمان را بمتر، پُرتر و گرمتر بشنویم.
میکروفن این لرزشهای داخلی را ضبط نمیکند. بنابراین وقتی صدای ضبطشدهمان را میشنویم، فقط نسخهای را میشنویم که از راه هوا منتقل شده؛ یعنی تقریباً همان صدایی که دیگران از ما میشنوند. به همین دلیل ممکن است صدا برایمان زیرتر، نازکتر یا غریبهتر به نظر برسد.
یک عامل روانشناختی هم وجود دارد: مغز سالها به نسخهی داخلی صدای ما عادت کرده است. وقتی ناگهان نسخهی دیگری از همان صدا را میشنود، بین «صدایی که انتظار داریم» و «صدایی که واقعاً ضبط شده» اختلاف ایجاد میشود. همین اختلاف است که باعث میشود خیلیها در اولین برخورد بگویند: «واقعاً صدای من اینه؟»
پس عجیب بودن صدای ضبطشده لزوماً به بد بودن صدا یا کیفیت پایین ضبط مربوط نیست؛ بیشتر نتیجهی این است که برای اولین بار داریم خودمان را تقریباً از گوش دیگران میشنویم.
وقتی حرف میزنیم، دقیقاً چه چیزی به گوش خودمان میرسد؟
برای فهمیدن ماجرا باید اول ببینیم صدا چگونه شنیده میشود.
وقتی فرد دیگری حرف میزند، ارتعاشهای صوتی در هوا حرکت میکنند، وارد مجرای گوش میشوند و پردهی گوش را به ارتعاش درمیآورند. این ارتعاش از طریق استخوانچههای گوش میانی به حلزون گوش داخلی میرسد و در نهایت به پیام عصبی تبدیل میشود.
هنگام شنیدن صدای خودمان، این مسیر همچنان وجود دارد؛ صدایی که از دهان خارج میشود، در محیط پخش میشود و بخشی از آن دوباره از راه هوا به گوش ما میرسد.
اما یک مسیر دوم هم فعال است.
ارتعاش ناشی از تولید صدا در حنجره و بافتهای اطراف، در سر و گردن منتشر میشود و بخشی از آن از طریق استخوانها و بافتهای بدن به گوش داخلی میرسد. مطالعات آکوستیکی نشان دادهاند که سهم هدایت هوایی و استخوانی در شنیدن صدای خودمان قابلتوجه است و نسبت این دو حتی با نوع آوایی که تلفظ میکنیم تغییر میکند.
در نتیجه، صدایی که ما هنگام صحبتکردن از خودمان میشنویم، صرفاً صدایی نیست که از دهانمان بیرون آمده است. مغز ترکیبی از چند ورودی صوتی و ارتعاشی را دریافت میکند.
هدایت استخوانی چیست؟
نام «هدایت استخوانی» ممکن است این تصور را ایجاد کند که صدا فقط از طریق استخوان جمجمه به گوش میرسد، اما سازوکار واقعی پیچیدهتر است. استخوانها، بافتهای نرم و ساختارهای مختلف سر در انتقال ارتعاش نقش دارند.
این ارتعاشها در نهایت بر ساختارهای گوش داخلی اثر میگذارند و سلولهای حسی حلزون گوش آنها را مانند سایر ارتعاشهای صوتی به پیام عصبی تبدیل میکنند.
به همین دلیل است که برای شنیدن صدا الزاماً نیازی نیست تمام انرژی صوتی از پردهی گوش عبور کند. هدفونهای هدایت استخوانی نیز از همین اصل استفاده میکنند و با ایجاد ارتعاش در استخوانهای اطراف گوش، بخشی از انرژی صوتی را به گوش داخلی میرسانند.
در مورد صدای خودمان این مسیر بهطور طبیعی، هر بار که صحبت میکنیم، وجود دارد.
آیا هدایت استخوانی واقعاً صدا را بمتر میکند؟
اینجا یک ظرافت مهم وجود دارد.
معمولاً گفته میشود هدایت استخوانی باعث میشود صدای خودمان را «بمتر» بشنویم. این توصیف از نظر تجربهی شنیداری درست است، اما به این معنی نیست که فرکانس پایهی صدای ما واقعاً پایینتر میآید.
آنچه تغییر میکند بیشتر ترکیب فرکانسی یا طیف صدا است.
انتقال صدا از طریق سر و بافتهای بدن بعضی بخشهای طیف صوتی را نسبت به بخشهای دیگر تقویت یا تضعیف میکند. پژوهشهای مربوط به ادراک صدای خود نشان دادهاند که افزودن ویژگیهای مرتبط با هدایت استخوانی میتواند یک صدای ضبطشده را برای شنونده شبیهتر به صدایی کند که هنگام صحبتکردن از خودش میشنود. با این حال، این اثر برای همهی افراد دقیقاً یکسان نیست.
بنابراین ممکن است صدای ضبطشده را «زیرتر» تصور کنیم، بدون آنکه فرکانس اصلی صدای ما در فایل ضبطشده واقعاً افزایش یافته باشد. چیزی که عوض شده، رنگ و تعادل فرکانسی صداست.
مغز صدای خودمان را فقط بهعنوان «یک صدا» نمیشناسد
تفاوت صدای زنده و ضبطشده فقط یک مسئلهی آکوستیکی نیست.
وقتی خودمان صحبت میکنیم، مغز چند نوع اطلاعات را همزمان دریافت میکند: صدایی که از هوا میآید، ارتعاشهای منتقلشده از بدن و اطلاعات حسی مربوط به حرکت حنجره، دهان و صورت.
به همین دلیل برخی پژوهشگران صدای خودمان را یک ادراک چندحسی میدانند، نه فقط یک محرک شنیداری.
در مطالعهای که در سال ۲۰۲۳ منتشر شد، پژوهشگران صدای افراد را همراه با تحریک هدایت استخوانی پخش کردند. اضافهشدن این مؤلفه باعث شد شرکتکنندگان در بعضی آزمایشها بهتر بتوانند صدای خودشان را از صدای دیگران تشخیص دهند. نتیجه نشان میدهد لرزشهایی که هنگام صحبتکردن احساس میکنیم واقعاً بخشی از تصویری هستند که مغز از «صدای من» ساخته است.
فایل صوتی معمولی بخش بزرگی از این اطلاعات را حذف میکند. مغز صدایی را میشنود که متعلق به ماست، اما دقیقاً با الگوی همیشگی «صدای خودم» مطابقت ندارد.
پس چرا صدای خودمان را در فایل باز هم میشناسیم؟
با وجود این تفاوت، بیشتر ما معمولاً میتوانیم صدای ضبطشدهی خود را تشخیص دهیم.
مغز برای تشخیص افراد فقط به بم یا زیر بودن صدا توجه نمیکند. ویژگیهای متعدد دیگری مانند ریتم حرفزدن، تلفظ، الگوی فرکانسی، شدت، آهنگ جمله و خصوصیات حنجره در هویت صوتی نقش دارند.
با این حال تشخیص صدای خودمان آنقدر هم که تصور میکنیم بیخطا نیست. در یکی از آزمایشهای مربوط به ادراک صدای خود، شرکتکنندگان در یک آزمون کنترل حدود ۷۹ درصد مواقع صدای ضبطشدهی خود را بهدرستی شناسایی کردند؛ یعنی حتی بدون دستکاری صدا نیز مواردی از اشتباه وجود داشت.
پژوهشهای تصویربرداری مغزی نیز نشان میدهند که مغز نسبت به صدای خودمان حساسیت ویژهای پیدا میکند. برای مثال، مطالعهای با fMRI نشان داد فعالیت بخشهایی از قشر شنوایی، از جمله شکنج گیجگاهی فوقانی، بسته به میزان شباهت صدای شنیدهشده به صدای خود فرد تغییر میکند. پژوهشگران این موضوع را با سالها مواجهه با صدای خود مرتبط میدانند.
چرا صدای ضبطشده در اولین برخورد تا این اندازه غریبه است؟
مغز ما از کودکی هزاران ساعت صدای خودمان را هنگام صحبتکردن شنیده است؛ اما تقریباً تمام این تجربهها شامل همان ترکیب هدایت هوایی، هدایت استخوانی و احساس ارتعاش بدن بودهاند.
در نتیجه مغز بهتدریج یک الگوی نسبتاً پایدار از «صدای خودم» میسازد.
وقتی صدای ضبطشده پخش میشود، بسیاری از نشانههای هویتی هنوز وجود دارند، اما بخشی از اطلاعاتی که همیشه همراه صدای خودمان بودهاند حذف شدهاند.
به زبان ساده، مغز همزمان دو پیام دریافت میکند:
این صدا از بسیاری جهات شبیه من است؛ اما دقیقاً شبیه صدایی نیست که انتظار دارم از خودم بشنوم.
همین ناهماهنگی یکی از دلایل احساس غریبگی است.
آیا صدای ضبطشده واقعاً همان صدایی است که دیگران از ما میشنوند؟
نه دقیقاً؛ اما معمولاً به آن نزدیکتر است.
دیگران هدایت استخوانی داخل جمجمهی ما را دریافت نمیکنند و عمدتاً صدایی را میشنوند که از دهان ما وارد هوا شده است. از این جهت، یک فایل ضبطشده نسبت به صدایی که خودمان هنگام حرفزدن میشنویم، تصویر بهتری از تجربهی دیگران ارائه میدهد.
اما ضبط صدا خودش فرایندی کاملاً خنثی نیست.
نوع میکروفن، فاصلهی دهان تا میکروفن، جهت میکروفن، آکوستیک اتاق، فشردهسازی فایل و حتی هدفون یا بلندگویی که صدا با آن پخش میشود میتوانند روی نتیجه تأثیر بگذارند. پژوهشهای مربوط به صدای خود نیز به همین مسئله اشاره کردهاند: شرایط ضبط و پخش میتواند تفاوت میان صدای ضبطشده و صدای طبیعی را بیشتر کند.
پس جملهی دقیقتر این است:
صدای ضبطشدهی باکیفیت معمولاً به چیزی که دیگران از ما میشنوند نزدیکتر است، اما نسخهی کاملاً یکسانی از آن نیست.
فردی که روبهروی ما ایستاده نیز صدا را در یک اتاق مشخص، از فاصله و زاویهی مشخص و با ویژگیهای شنوایی مخصوص خودش دریافت میکند.
چرا بعضی میکروفنها صدایمان را عجیبتر میکنند؟
اگر یک بار صدای خود را با گوشی و بار دیگر با یک میکروفن حرفهای ضبط کنید، احتمالاً تفاوت را متوجه میشوید.
میکروفنها پاسخ فرکانسی یکسانی ندارند. بعضی مدلها بخشهایی از فرکانسهای پایین را تقویت میکنند و بعضی روی محدودههایی که به وضوح گفتار کمک میکنند تأکید بیشتری دارند.
فاصله هم مهم است. بعضی میکروفنهای جهتدار وقتی بسیار نزدیک دهان قرار میگیرند، فرکانسهای پایین را بیشتر ثبت میکنند؛ پدیدهای که در مهندسی صدا به آن «اثر مجاورت» یا Proximity Effect گفته میشود.
پردازش نرمافزاری گوشیها نیز میتواند حذف نویز، فشردهسازی، تنظیم خودکار شدت صدا و پردازشهای دیگری روی فایل اعمال کند.
بنابراین اگر صدایتان در یک پیام صوتی با صدایی که در یک استودیوی حرفهای ضبط شده متفاوت است، الزاماً به این معنا نیست که یکی «صدای واقعی» و دیگری «صدای غیرواقعی» است. هرکدام نمونهای از صدای شما هستند که در شرایط متفاوت ثبت شدهاند.
آیا همه از شنیدن صدای ضبطشدهی خود بدشان میآید؟
نه.
غریبهبودن یک صدا و دوستنداشتن آن دو موضوع متفاوتاند.
ممکن است کسی در اولین برخورد از تفاوت صدایش تعجب کند، اما ارزیابی منفی از آن نداشته باشد. عوامل روانشناختی و نگرش فرد نسبت به خودش نیز میتوانند در میزان رضایت از صدای ضبطشده نقش داشته باشند.
پژوهشی که در سال ۲۰۲۴ روی ۱۷۶ فرد دوزبانه انجام شد، ارتباطی میان نشانههای بیشتر اضطراب اجتماعی و ارزیابی منفیتر افراد از صدای خود پیدا کرد. این یافته به معنای آن نیست که هرکس صدای ضبطشدهاش را دوست ندارد اضطراب اجتماعی دارد؛ فقط نشان میدهد قضاوت ما دربارهی صدای خود میتواند علاوه بر آکوستیک، تحتتأثیر عوامل روانشناختی نیز باشد.
آیا میتوانیم به صدای ضبطشدهی خود عادت کنیم؟
بله، معمولاً مواجههی بیشتر با صدای ضبطشده باعث میشود احساس غریبگی کمتر شود.
نکته این نیست که ساختمان گوش یا هدایت استخوانی تغییر میکند. آنچه تغییر میکند تجربهی ماست. مغز بهتدریج با نسخهی هوایی و ضبطشدهی صدایمان نیز آشناتر میشود.
به همین دلیل افرادی که مرتب صدای خود را ضبط و ویرایش میکنند ــ مانند گویندگان، پادکسترها، خوانندگان یا تولیدکنندگان محتوا ــ معمولاً کمتر از شنیدن صدای ضبطشدهی خود تعجب میکنند.
با این حال حتی برای آنها نیز صدایی که هنگام صحبتکردن در لحظه میشنوند با صدای پخششده از بلندگو کاملاً یکسان نیست؛ زیرا مسیر هدایت استخوانی همچنان فقط هنگام تولید صدا وجود دارد.
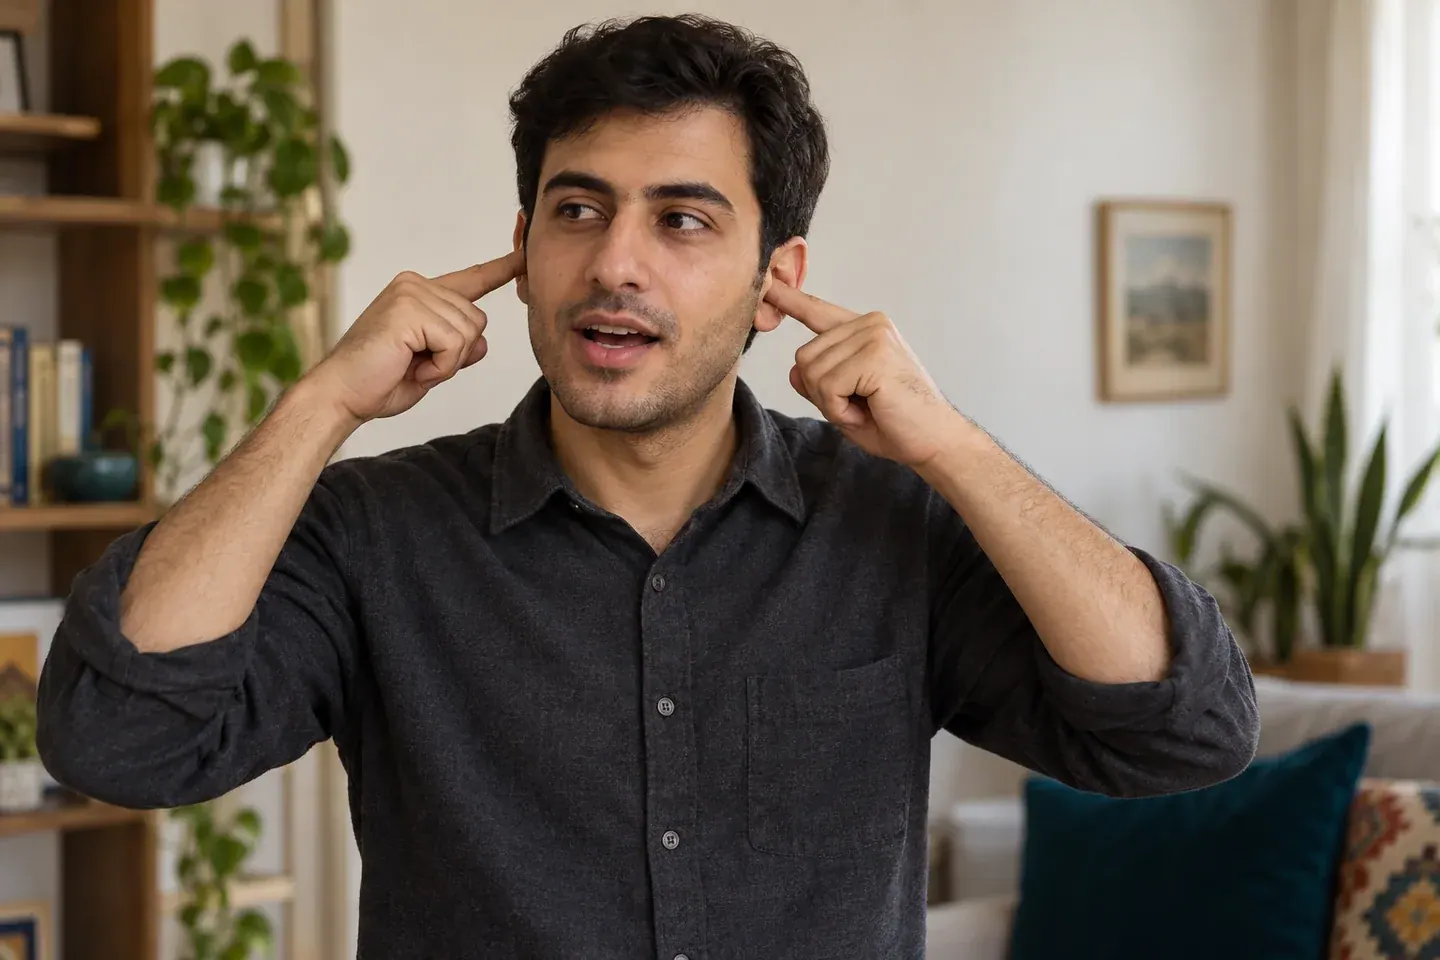
یک آزمایش ساده
میتوانید بخشی از این تفاوت را بدون هیچ وسیلهی خاصی احساس کنید.
یک جمله را با صدای معمولی بگویید و به صدای خود توجه کنید. سپس همان جمله را ضبط کنید و با یک هدفون نسبتاً خوب گوش دهید.
حالا هنگام حرفزدن، گوشهای خود را ببندید. صدای خودتان متفاوت و معمولاً پُرتر به نظر میرسد، زیرا سهم صداهای منتقلشده از طریق بدن نسبت به صدای محیط بیشتر شده است.
این آزمایش دقیق آزمایشگاهی نیست، اما بهخوبی نشان میدهد صدایی که هنگام صحبتکردن تجربه میکنیم فقط محصول صدایی نیست که در هوای اطرافمان منتشر میشود.
در نهایت کدامیک «صدای واقعی» ماست؟
از نظر علمی بهتر است اصلاً دنبال یک نسخهی واحد به نام «صدای واقعی» نباشیم.
صدایی که تولید میکنیم یک پدیدهی فیزیکی است، اما چیزی که شنیده میشود به مسیر انتقال، محیط و دستگاه شنونده وابسته است.
خودمان هنگام صحبتکردن ترکیبی از هدایت هوایی و هدایت درون بدن را میشنویم. فرد روبهرو نسخهای را میشنود که در هوا و محیط اطراف منتشر شده است. میکروفن هم همان میدان صوتی را با ویژگیهای فنی خودش ثبت میکند.
به همین دلیل صدای ضبطشدهی ما جعلی یا غیرواقعی نیست. فقط نسخهای از صدای ماست که معمولاً آن را کمتر از نسخهای که از داخل سر خود میشنویم تجربه کردهایم.
و احتمالاً مهمترین دلیل آن لحظهی معروف ــ «یعنی من واقعاً اینطوری حرف میزنم؟» ــ همین است.